Lois discrètes
La page précédente a posé les outils pour décrire une v.a. discrète, loi de masse, fonction de répartition, espérance, variance, indépendance (§3), et la synthèse qui les chapeaute : une loi est un modèle paramétré
Chaque loi est un modèle du hasard
Loi de Bernoulli,
La loi de Bernoulli modélise toute expérience à deux issues, succès (
Modélisation
La loi de Bernoulli est paramétrée par
Modèle (Loi de Bernoulli)
- PMF :
- CDF :
À titre d'exemple, pour le problème de pile ou face (
Illustration
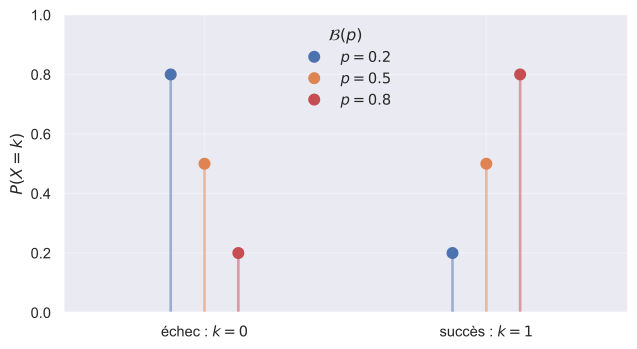
Figure 1.11a, PMF :
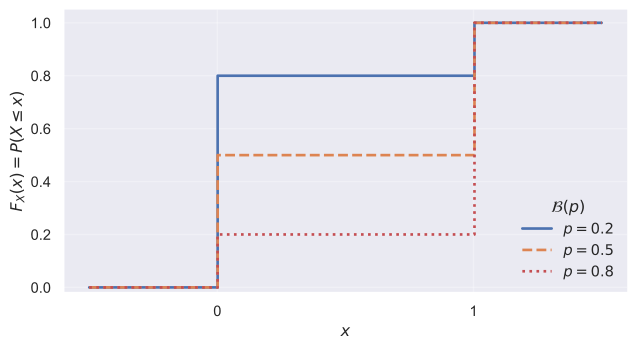
Figure 1.11b, CDF : deux marches, en
Propriétés
Moments
La variance
Preuve
Exemple
Le code suivant montre comment simuler 50 000 tirages de Bernoulli de paramètre
import numpy as np
rng = np.random.default_rng(0)

p = 0.05
x = (rng.random(50_000) < p).astype(int)
x.mean()    # >>> 0.0501  (fréquence ≈ p)
x.var() # >>> 0.0476 (≈ p(1-p) = 0.0475)import scipy.stats as sta
X = sta.bernoulli(0.05)
X.mean(), X.var() # >>> (0.05, 0.0475)Loi binomiale,
La loi binomiale compte les succès sur
Modélisation
La loi binomiale est paramétrée par
Modèle (Loi binomiale)
- PMF :
- CDF :
Notons qu'il n'y a pas de forme simple pour la CDF. L'expression s'obtient en sommant la PMF sur les différentes valeurs de
Illustration
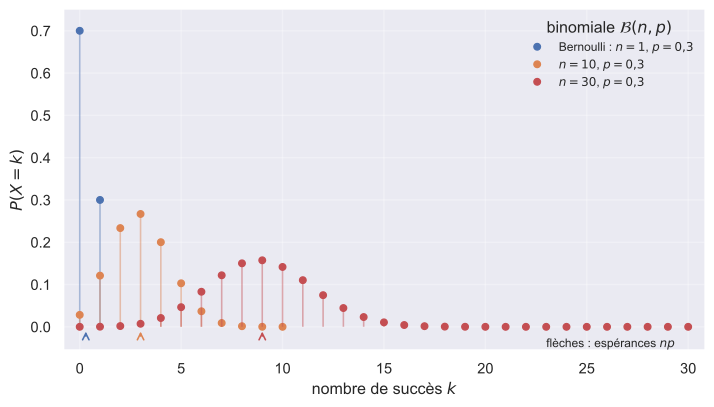
Figure 1.12a, PMF : le cas
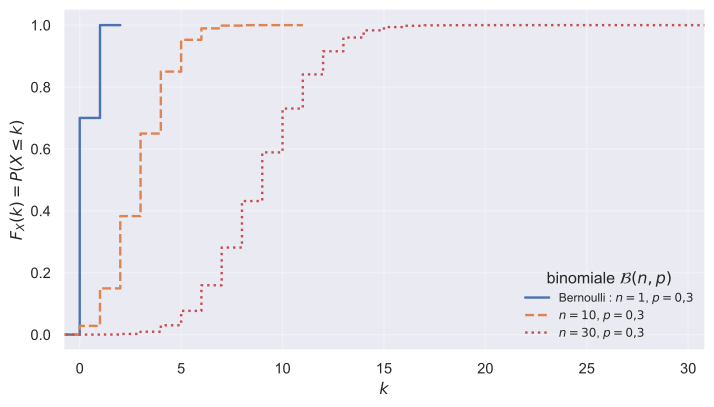
Figure 1.12b, CDF : un escalier à
Propriétés
Moments
La binomiale est une somme de
Preuve
Exemple
Le code suivant montre comment simuler 100 000 trames de
import numpy as np
rng = np.random.default_rng(0)

n, p = 1000, 0.02
bits = rng.random((100_000, n)) < p   # n Bernoulli(p) indépendants, 100 000 trames simulées
erreurs = bits.sum(axis=1)            # X = somme de n Bernoulli = Binomiale(n, p)
erreurs.mean(), erreurs.var()   # >>> (19.998, 19.574)  (≈ np = 20, np(1-p) = 19.6)
(erreurs == 20).mean() # >>> 0.0906 (≈ P(X=20) = 0.0897)import scipy.stats as sta
X = sta.binom(1000, 0.02)
X.pmf(20) # >>> 0.0897
X.sf(29) # >>> 0.0207 (P(X >= 30))
X.mean(), X.var() # >>> (20.0, 19.6)Au chapitre 2 : déduire le taux d'erreur
Loi géométrique,
La loi géométrique modélise l'attente du premier succès : le nombre de combats avant d'obtenir un objet rare (probabilité
Modélisation
La loi géométrique est paramétrée par
Modèle (Loi géométrique)
- PMF :
- CDF :
La quantité
Illustration
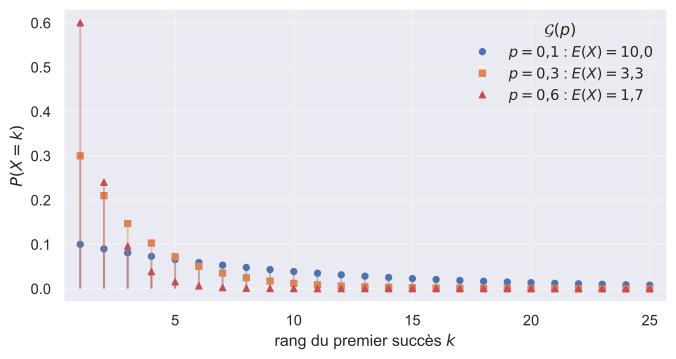
Figure 1.13a, PMF : plus le succès est rare, plus la loi s'étale.
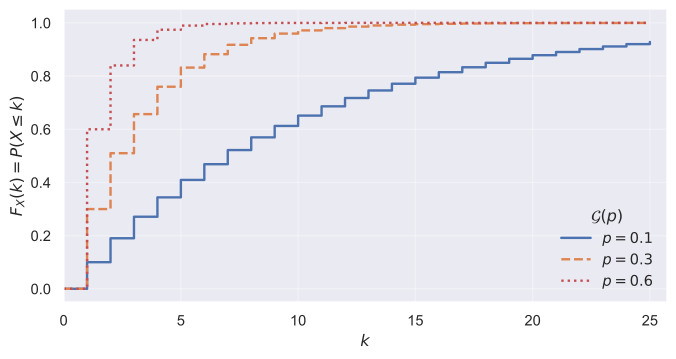
Figure 1.13b, CDF :
Propriétés
Moments
L'écart-type est du même ordre que la moyenne : l'attente d'un événement rare est intrinsèquement très dispersée.
L'absence de mémoire
Proposition, Absence de mémoire (géométrique)
Si
Avoir déjà échoué
Démonstration
Exemple
Le code suivant montre comment repérer le rang du premier succès sur 100 000 séries de 400 tentatives, avec un taux de succès
import numpy as np
rng = np.random.default_rng(0)

p = 0.05
essais = rng.random((100_000, 400)) < p
# tant que la somme cumulée des succès est nulle, aucun succès n'est encore survenu ;
# le nombre de tels essais est donc le rang (0-based) du premier succès
premier = (essais.cumsum(axis=1) == 0).sum(axis=1) + 1
premier.mean(), premier.var() # >>> (19.99, 375.6) (≈ 1/p = 20, (1-p)/p² = 380)import scipy.stats as sta
X = sta.geom(0.05)
X.mean(), X.var() # >>> (20.0, 380.0)
X.sf(20) # >>> 0.3585 (P(X > 20) = 0.95^20)Au chapitre 2 : estimer ce taux à partir des rangs d'apparition observés.
Loi de Poisson,
La loi de Poisson modélise le comptage d'événements rares dans une fenêtre fixe : requêtes reçues par un serveur en une seconde, pannes d'un parc de machines par mois.
Modélisation
La loi de Poisson est paramétrée par
Modèle (Loi de Poisson)
- PMF :
- CDF :
Illustration
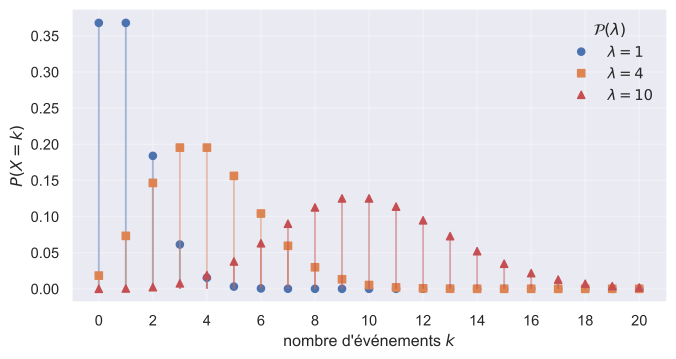
Figure 1.14a, PMF : le pic suit
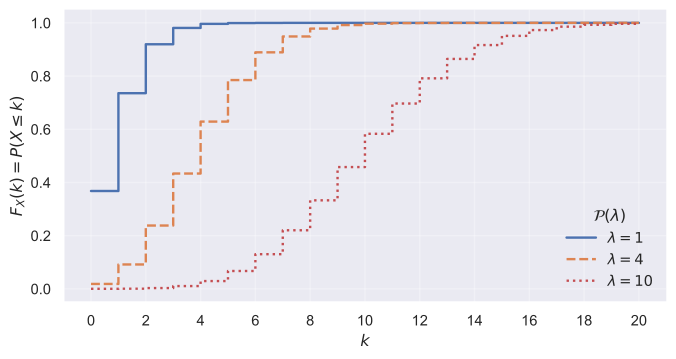
Figure 1.14b, CDF : escalier, de plus en plus étiré à droite quand
Propriétés
Moments
L'égalité
Preuve
Exemple
Le code suivant montre comment compter les requêtes reçues par un serveur de taux
import numpy as np
rng = np.random.default_rng(0)

lam, n = 4, 2000                 # la seconde découpée en n sous-intervalles, p = lam/n minuscule
p = lam / n
requetes = (rng.random((100_000, n)) < p).sum(axis=1)   # Binomiale(n, p) --> Poisson(lam) quand n est grand
requetes.mean(), requetes.var()   # >>> (4.01, 3.98)  (≈ lam = 4)
(requetes == 4).mean()            # >>> 0.195  (≈ P(X=4) = 0.1954, valeur la plus probable : 20 % seulement)
(requetes >= 10).mean() # >>> 0.0077 (≈ P(X>=10) = 0.0081 : saturation)import scipy.stats as sta
X = sta.poisson(4)
X.pmf(4), X.sf(9) # >>> (0.1954, 0.0081) (P(X >= 10) : saturation)
X.mean(), X.var() # >>> (4.0, 4.0)Au chapitre 2 : le trafic réel donne des comptages
Loi uniforme discrète,
La loi uniforme discrète modélise un nombre fini de valeurs toutes équiprobables : le dé, désormais nommé, ou le tirage d'un indice dans une liste, la brique de toutes les simulations.
Modélisation
La loi uniforme discrète est paramétrée par
Modèle (Loi uniforme discrète)
- PMF :
- CDF :
Illustration
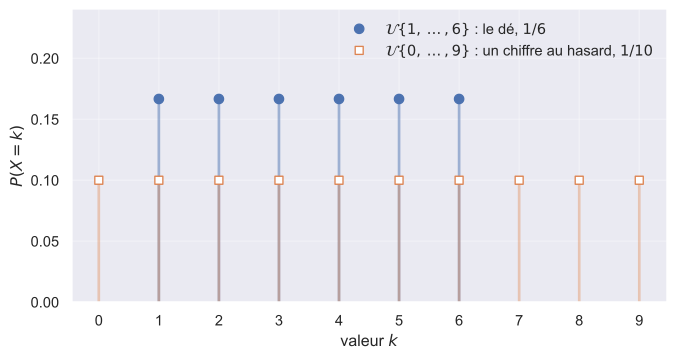
Figure 1.15a, PMF : le dé (
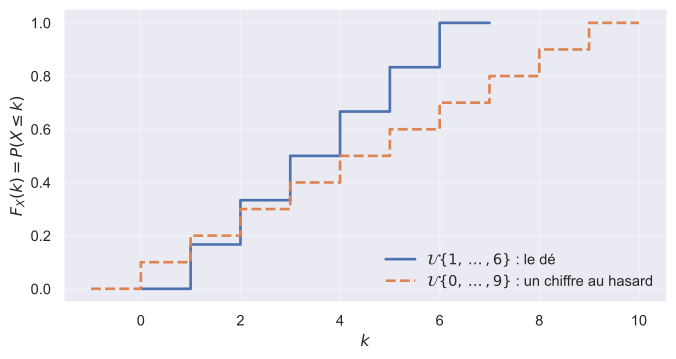
Figure 1.15b, CDF : marches régulières de hauteur
Propriétés
Moments
Le centre est le milieu de l'intervalle ; la dispersion croît avec l'étendue du support, au carré.
Exemple
Le code suivant montre comment tirer 100 000 lancers d'un dé à six faces (
import numpy as np
rng = np.random.default_rng(0)

lancers = rng.integers(1, 7, size=100_000)
lancers.mean(), lancers.var() # >>> (3.498, 2.910) (≈ 3.5, 35/12 ≈ 2.917)import scipy.stats as sta
X = sta.randint(1, 7) # borne haute exclue
X.mean(), X.var() # >>> (3.5, 2.9167)