Skip to content

Fondations : estimateur, MSE, CRLB

Cette page pose les outils pour juger un estimateur, sans encore dire comment en construire un. La section 1 définit ce qu'est un estimateur et montre, sur un exemple, qu'il s'agit d'une variable aléatoire. La section 2 en tire les trois quantités qui le caractérisent, biais, variance et MSE. La section 3 montre comment les estimer par simulation lorsque le calcul analytique n'aboutit pas. La section 4 reporte cette incertitude sur le résultat lui-même, sous la forme d'un intervalle de confiance. La section 5 lève la dernière hypothèse commode, celle d'une variance connue.

1. Problématique

⚠ Bascule de notation

Le chapitre 1 écrivait X (majuscule) la variable aléatoire et x (minuscule) sa réalisation, une distinction utile pour apprendre à voir le hasard. À partir de maintenant, nous suivons la convention de Kay : une seule casse, x[n], pour la variable aléatoire et sa réalisation ; le contexte tranche. De même θ^ désignera aussi bien l'estimateur (une fonction des données, donc une v.a.) que l'estimation qu'il produit sur un jeu de données particulier (un nombre).

Modèle d'estimateur

Considérons que nous disposons de données x=[x[0],,x[N1]]T, modélisées par une loi p(x;θ) à un paramètre θ inconnu. Un estimateur de θ est une fonction des données censée approcher la valeur de θ. Mathématiquement, un estimateur peut s'exprimer sous la forme d'une fonction :

θ^=g(x)

  • g est une fonction des données, choisie par nous,
  • θ^ est lui-même une variable aléatoire, puisque fonction de données aléatoires : il possède une loi, une espérance et une variance.

Confusion

Attention à ne pas confondre la valeur vraie θ et son estimation θ^.

Exemple : estimation de la borne supérieure

Une machine produit des pièces dont la cote varie uniformément entre 0 et une valeur maximale θ qui lui est propre ; nous mesurons N pièces et cherchons θ. Le modèle est donc N mesures i.i.d. x[n]U(0,θ), une loi uniforme continue (fiche uniforme) dont le seul paramètre inconnu est aussi la borne supérieure du support.

Répétons trois fois la même expérience, huit mesures à chaque fois, et plaçons les valeurs obtenues sur un axe.

Trois séries de huit points gris répartis entre 0 et 10 sur un axe horizontal ; une
            verticale noire pointillée à 10 marque la valeur de theta, qu'aucun point n'atteint.

Figure 2.1a, Trois répétitions indépendantes de la même expérience, N=8 mesures tirées selon U(0,θ) avec θ=10 (script figures/ch2/01-echantillon-uniforme.py).

Les points se répartissent sans privilégier aucune zone, c'est le propre de la loi uniforme, et aucun ne dépasse θ, qui borne le support. Chaque série suggère donc une réponse : θ se trouve quelque part au-dessus de la plus grande valeur observée. Mais cette plus grande valeur change d'une série à l'autre, 9,1, 9,7, puis seulement 6,6, et elle reste toujours en deçà de θ.

Trois candidats se présentent pour estimer θ :

θ^1=maxnx[n],θ^2=maxnx[n]minnx[n],θ^3=2x¯=2Nnx[n].

θ^1 mise sur l'observation la plus informative : aucune mesure ne peut dépasser θ, donc la plus grande mesure observée doit en être proche. θ^2 retranche la plus petite mesure, dans l'idée de corriger un possible décalage. θ^3 mobilise toutes les mesures à la fois via la moyenne empirique (chapitre 1) : E(x¯)=θ/2, donc θ^3 vise juste en espérance. Trois fonctions légitimes des données, donc trois variables aléatoires. Laquelle choisir ? Il faut un critère de comparaison.

Illustration

Fixons θ=10 et tirons une seule série de 200 mesures ; à chaque N, recalculons les trois estimateurs sur les N premières mesures de cette même série.

Valeur des trois estimateurs en fonction de N, sur un seul tirage, comparée à la valeur vraie theta=10

Figure 2.1b, Les trois estimateurs recalculés sur les N premières mesures d'un même tirage (θ=10), comparés à la valeur vraie (script figures/ch2/01-fondations.py).

Les trois courbes se rapprochent de θ=10 quand N grandit, mais à des vitesses très différentes, θ^1 colle à la cible presque immédiatement, θ^3 tâtonne plus longtemps. Ce graphe n'est qu'une seule réalisation pour une meme valeur de θ : un autre tirage déplacerait les trois courbes, sans changer leur allure générale. Comparer des estimateurs sur un tirage unique est donc fragile. Il faut un critère qui résume leur comportement sur l'ensemble des tirages possibles.

2. Métriques de performance : Biais, variance et MSE

Comment résumer, en un seul nombre, la qualité d'un estimateur sur l'ensemble de ses tirages possibles ? La mesure la plus naturelle est une distance moyenne à la cible, l'erreur quadratique moyenne, l'espérance du carré de l'écart entre l'estimateur et la vraie valeur.

Définition

Définition, Erreur quadratique moyenne (MSE)

MSE(θ^)=E((θ^θ)2).

  • θ^=g(x) est l'estimateur évalué,
  • θ est la valeur vraie, inconnue en pratique.

⚠ Statut de θ

La définition de MSE(θ^) suppose θ déterministe mais inconnu, l'approche fréquentiste, celle que rappelle le point-virgule de p(x;θ). Le §4 des estimateurs usuels assignera au contraire une loi à θ, et la notation basculera alors en p(xθ).

Cette quantité peut se décomposer en deux termes de natures différentes.

Définition, Biais et variance

Pour un estimateur θ^ de θ :

MSE(θ^)=var(θ^)+b(θ^)2

  • b(θ^)=E(θ^)θ correspond au biais de l'estimateur,
  • var(θ^)=E((θ^E(θ^))2) correspond à la variance de l'estimateur.
Preuve

Posons m=E(θ^) et insérons-le :

θ^θ=(θ^m)+(mθ).

Le second terme, mθ, est une constante (il ne dépend pas des données). En développant le carré et en prenant l'espérance, le terme croisé s'annule car E(θ^m)=0 :

MSE(θ^)=E((θ^m)2)dispersion autour de m+2(mθ)E(θ^m)=0+(mθ)2écart entre m et θ.

Le biais mesure une erreur systématique (nous visons à côté, toujours du même côté) ; la variance mesure une erreur de fluctuation (nous dispersons autour de notre propre cible). La MSE les réunit en un seul nombre, mais un nombre ne dit pas lequel des deux défauts pèse le plus.

Propriétés

En pratique, nous n'aurons pas de technique sur étagère pour choisir l'estimateur optimal g(.). Néanmoins, dans la classe des estimateurs sans biais, il sera possible de comparer la variance de n'importe quel estimateur avec une borne présentant la variance optimale. Lorsqu'un estimateur sans biais atteint cette borne, il deviendra de facto optimal.

Théorème, Borne de Cramér-Rao (CRLB)

Pour tout estimateur sans biais θ^=g(x) de θ (sous conditions de régularité) :

var(θ^)  1I(θ).

I(θ) correspond à l'information de Fisher et est définie par :

I(θ)=E[2(θ)θ2].

et (θ)=lnp(x;θ) correspond à la log-vraisemblance.

Illustration

Cette décomposition se lit aussi sur un schéma classique : imaginez trois séries de tirs sur une cible, chaque tir étant une estimation θ^ obtenue sur un tirage différent, et le centre marquant la valeur vraie θ.

Trois cibles : tirs groupés mais décalés du centre ; tirs dispersés mais centrés en moyenne ; tirs groupés et proches du centre malgré un léger décalage

Figure 2.1c, Trois cibles, de gauche à droite : tirs groupés mais décalés du centre (biais fort, variance faible) ; tirs dispersés mais centrés en moyenne (sans biais, variance forte) ; tirs groupés et proches du centre malgré un léger décalage (biais faible, MSE la plus faible des trois) (script figures/ch2/01-fondations.py).

Le biais déplace le nuage de tirs loin du centre ; la variance l'étale autour de sa propre moyenne. Les cibles de gauche et du centre n'illustrent chacune qu'un seul défaut, et leur MSE reste élevée, celle de gauche à cause du biais, celle du centre à cause de la variance. La cible de droite cumule un peu des deux, un biais non nul et une variance non nulle, mais tous deux petits : sa MSE est la plus faible des trois. Un peu de biais, bien maîtrisé, peut valoir mieux qu'aucun biais du tout.

Exemple : estimation de la borne supérieure

En utilisant les propriétés de l'espérance mathématique, il est parfois possible d'obtenir analytiquement l'expression de la MSE, du biais et de la variance d'un estimateur.

Pour les trois candidats du §1 (x[n] i.i.d. U(0,θ)), le tableau suivant présente les propriétés de chaque estimateur.

θ^1=maxθ^2=maxminθ^3=2x¯
BiaisθN+12θN+10
VarianceNθ2(N+1)2(N+2)2(N1)θ2(N+1)2(N+2)θ23N
MSE2θ2(N+1)(N+2)6θ2(N+1)(N+2)θ23N
Calcul des moments de θ^1 et θ^3

Sous indépendance, P(θ^1x)=P(tous les x[n]x)=FX(x)N=(x/θ)N sur [0,θ], la CDF du maximum s'obtient en élevant celle d'une seule mesure à la puissance N (fonction de répartition). En dérivant, la densité est f(N)(x)=NxN1/θN, d'où

E(θ^1)=0θxNxN1θNdx=NN+1θ,E(θ^12)=NN+2θ2,

et var(θ^1)=E(θ^12)E(θ^1)2=Nθ2/((N+1)2(N+2)) par König-Huygens. Pour θ^3, le corollaire sur la loi de la moyenne empirique donne var(x¯)=σ2/N avec σ2=θ2/12 (fiche uniforme), d'où var(2x¯)=4σ2/N=θ2/(3N). Les moments de θ^2 s'obtiennent de façon analogue, à partir de la loi jointe du couple (min, max), nous les admettons ici.

Un seul de ces estimateurs est sans biais, θ^3, et pourtant ce n'est pas lui qui présente la MSE la plus faible. En effet, MSE(θ^1) et MSE(θ^2) décroissent en 1/N2, bien plus vite que MSE(θ^3), qui décroît seulement en 1/N. Dès N=3, le maximum biaisé a donc une MSE plus petite que la moyenne sans biais, et l'écart se creuse ensuite. Entre les deux estimateurs biaisés, θ^1 l'emporte partout sur θ^2, d'un facteur 3 exactement.

Illustration

Trois panneaux empilés en fonction de N : le biais en échelle linéaire, négatif pour
            les deux premiers estimateurs et nul pour le troisième ; la variance et la MSE en
            échelle log-log, où les courbes deviennent des droites de pentes différentes.

Figure 2.1d, Biais, variance et MSE des trois estimateurs en fonction de N (θ=10), N2 ; variance et MSE en échelle log-log (script figures/ch2/01-fondations.py).

En échelle log-log, une décroissance en 1/Nk devient une droite de pente k : les MSE de θ^1 et θ^2 y sont deux fois plus pentues que celle de θ^3, l'écart en 1/N2 contre 1/N se lisant directement. Le biais reste en échelle linéaire, ses valeurs étant négatives et nulles pour θ^3.

3. Simulation de Monte-Carlo

Les trois définitions du §2 posent une difficulté pratique immédiate. Elles reposent toutes sur une espérance, rarement calculable analytiquement dès que l'estimateur s'écarte des quelques cas d'école. La simulation de Monte-Carlo contourne cet obstacle : elle génère B réalisations de la variable aléatoire θ^, puis remplace chaque espérance par une moyenne empirique sur ces B valeurs.

Définition

Définition, Estimation Monte-Carlo du biais, de la variance et de la MSE

Soient θ^(1),,θ^(B) les estimations obtenues sur B répétitions indépendantes de l'expérience, et θ^=1Bbθ^(b) leur moyenne empirique. Le biais, la variance et la MSE s'estiment par

b^=θ^θ,var^=1Bb=1B(θ^(b)θ^)2,MSE^=1Bb=1B(θ^(b)θ)2.

Ces trois expressions se justifient par la loi des grands nombres : une moyenne empirique se rapproche de l'espérance qu'elle estime à mesure que B grandit. La qualité de l'estimation dépend donc directement de B. Une valeur trop faible laisse subsister des fluctuations, une valeur trop élevée allonge le temps de simulation.

Implémentation

La mise en œuvre suit toujours les trois mêmes étapes, quelle que soit la loi des données et quel que soit l'estimateur étudié :

  1. simuler un jeu de N mesures selon le modèle, avec une valeur de θ que nous fixons ;
  2. estimer θ^ sur ce jeu, en appliquant l'estimateur à évaluer ;
  3. répéter B fois, puis moyenner selon les trois formules ci-dessus.

Seules les deux premières étapes dépendent du problème traité. Elles s'isolent donc dans deux fonctions, simulate et g, que le reste du code ne fait qu'appeler :

python
import numpy as np
rng = np.random.default_rng(2026)

theta, N, B = 10.0, 8, 100_000

def simulate(theta, N):
    """Draw N measurements from the model, here x[n] ~ U(0, theta)."""
    return rng.uniform(0, theta, size=N)

def g(x):
    """The estimator under study: from data to an estimate of theta."""
    return x.max()

# steps 1 and 2, repeated B times: B estimates of theta
theta_hat = np.empty(B)
for b in range(B):
    x = simulate(theta, N)      # one repetition of the experiment
    theta_hat[b] = g(x)         # the corresponding estimate

# step 3: each expectation becomes an average over these B values
bias = theta_hat.mean() - theta
variance = theta_hat.var()
mse = ((theta_hat - theta) ** 2).mean()

Changer d'estimateur revient à changer le corps de g, changer de modèle à changer celui de simulate : le reste du code est inchangé. Lorsque l'estimateur s'exprime de façon vectorielle, comme ici avec max, il est plus rapide de remplacer la boucle par un unique tirage dans un tableau B×N, puis d'appliquer l'estimateur ligne par ligne.

Exemple

Appliquons cette méthode à θ^1=maxnx[n] pour N variable, en confrontant sa MSE théorique à son estimation Monte-Carlo pour deux valeurs de B.

MSE de theta_1 en fonction de N en échelle log-log : une droite noire épaisse pour la
            valeur théorique, une courbe orange à B = 10 qui oscille fortement autour, et une
            courbe bleue à B = 100 qui la serre de plus près.

Figure 2.2, MSE de θ^1=maxnx[n] en fonction de N (θ=10), valeur théorique 2θ2/((N+1)(N+2)) et estimations Monte-Carlo pour B=10 et B=100, en échelle log-log (script figures/ch2/01-monte-carlo-convergence.py).

Les deux estimations suivent la décroissance théorique sans jamais s'en écarter systématiquement : elles oscillent autour de la courbe, tantôt au-dessus, tantôt en dessous. C'est la signature d'un estimateur sans biais de la MSE, et c'est ce qui rend la méthode fiable. Leur dispersion, en revanche, diffère nettement. À B=10, l'écart à la valeur théorique atteint 104% et vaut 46% en médiane : dix répétitions ne permettent pas de conclure. À B=100, il tombe à 17% en médiane. Multiplier B par dix a donc divisé l'écart typique par 2,7, proche du facteur 103,2 attendu, la précision d'une moyenne empirique progressant en 1/B. Atteindre une décimale sûre exige de ce fait des B de l'ordre de 104, ce qui reste bon marché : le coût est du temps de calcul, jamais des mesures supplémentaires.

Cette technique dépasse largement l'exemple : dès qu'un estimateur est trop compliqué pour un calcul analytique, ce qui est la règle plutôt que l'exception, la simulation de Monte-Carlo reste disponible, et c'est alors le seul accès à son risque.

4. Intervalle de confiance

Le biais, la variance et la MSE jugent un estimateur sur l'ensemble de ses tirages possibles. Le résultat livré à l'utilisateur reste pourtant un nombre unique, une estimation dont rien n'indique la précision. Comment reporter, à côté de l'estimation, l'incertitude qui l'accompagne ? La réponse consiste à remplacer ce nombre par un intervalle, dont les deux bornes sont elles aussi calculées sur les données.

Définition

Définition, Intervalle de confiance

Un intervalle de confiance de niveau 1α pour θ est un intervalle aléatoire [θ^inf, θ^sup] vérifiant

P(θ^infθθ^sup)=1α,

  • θ^inf=ginf(x) et θ^sup=gsup(x) sont deux fonctions des données, donc deux variables aléatoires,
  • θ est la valeur vraie, déterministe et inconnue,
  • 1α est le niveau de confiance, et α le risque toléré.

Dans cette probabilité, θ est une constante : l'aléa provient exclusivement des deux bornes, qui changent d'un jeu de données à l'autre. Le niveau 1α mesure donc une fréquence de couverture, la proportion des expériences répétées où l'intervalle construit contient la valeur vraie. C'est une propriété de la procédure, au même titre que le biais ou la MSE du §2.

Confusion classique

« Il y a 95% de chances que θ appartienne à [2,23 ; 2,35]. » Non : une fois les données observées, les deux bornes sont des nombres, et θ en est un également. Soit θ appartient à cet intervalle, soit il ne lui appartient pas ; cette proposition est vraie ou fausse, et aucune probabilité intermédiaire ne lui est attachée.

Propriétés

Construire un intervalle de confiance exige de connaître la loi de l'estimateur. Le cas de la moyenne empirique d'un échantillon Gaussien se traite exactement, à partir de la loi de la moyenne empirique.

Proposition, Intervalle de confiance de la moyenne d'une Gaussienne

Soient x[n]N(θ,σ2) i.i.d. avec σ connu, et θ^=x¯. L'intervalle

[ x¯z1α/2σN ,  x¯+z1α/2σN ]

est de niveau exactement 1α, où

  • z1α/2 est le quantile d'ordre 1α/2 de la loi N(0,1),
  • z0,975=1,96 pour un niveau de confiance de 95%.
Démonstration

La moyenne empirique de N mesures Gaussiennes i.i.d. suit x¯N(θ,σ2/N), donc la variable centrée réduite

z=x¯θσ/N

suit N(0,1), quel que soit N. Par symétrie de cette loi, P(|z|z1α/2)=1α. Isoler θ dans cette double inégalité donne l'intervalle annoncé : le paramètre n'a pas changé de statut, seule l'écriture a déplacé l'aléa des données vers les bornes.

La demi-largeur z1α/2σ/N vaut z1α/2var(θ^) : l'intervalle n'est rien d'autre que l'écart-type du §2, rendu lisible sur l'axe des valeurs du paramètre. Sa décroissance en 1/N fixe le prix de la précision, quadrupler le nombre de mesures pour diviser la largeur par deux. Deux restrictions accompagnent cette construction. La loi de θ^ est rarement Gaussienne exactement, et σ est rarement connu ; l'un et l'autre se remplacent alors par une approximation valable pour N grand, comme le fera l'intervalle asymptotique du maximum de vraisemblance.

Confusion classique

« L'intervalle contient 95% des mesures. » Non : il porte sur le paramètre θ, pas sur les données. Sa largeur décroît d'ailleurs quand N augmente, alors que la dispersion des mesures, elle, ne dépend pas de leur nombre.

Implémentation

La couverture annoncée se vérifie par simulation, en reprenant les trois étapes du §3 :

  1. simuler un jeu de N mesures selon le modèle, avec une valeur de θ que nous fixons ;
  2. construire l'intervalle sur ce jeu, puis tester s'il contient θ ;
  3. répéter B fois, puis compter la proportion d'intervalles qui le contiennent.
python
import numpy as np
rng = np.random.default_rng(2026)

theta, sigma, N, B = 2.30, 0.10, 10, 100_000
z = 1.96

def simulate(theta, sigma, N):
    """Draw N measurements from the model, here x[n] ~ N(theta, sigma^2)."""
    return rng.normal(theta, sigma, size=N)

def confidence_interval(x, sigma, z):
    """Two-sided interval centred on the sample mean, half-width z*sigma/sqrt(N)."""
    half_width = z * sigma / np.sqrt(len(x))
    return x.mean() - half_width, x.mean() + half_width

# steps 1 and 2, repeated B times: count the intervals that catch theta
covered = 0
for b in range(B):
    x = simulate(theta, sigma, N)               # one repetition of the experiment
    lower, upper = confidence_interval(x, sigma, z)
    if lower <= theta <= upper:
        covered += 1

# step 3: the coverage is a frequency over repetitions, not a probability on theta
coverage = covered / B                          # >>> 0.9495  (predicted: 0.95)

Ce calcul n'est possible qu'en simulation, où θ est fixé par nous. Face à des données réelles, θ reste inconnu et la couverture n'est jamais observable.

Exemple : mesure d'une tension

Un voltmètre bruité mesure N=10 fois la même tension continue, avec un écart-type de bruit σ=0,10 V connu par la notice de l'appareil. Les dix mesures donnent x¯=2,288 V, et la demi-largeur vaut 1,96×0,10/10=0,062 V, d'où l'intervalle de confiance à 95%

[2,226 ; 2,350] V.

Cet intervalle contient-il la vraie tension ? Sur des données réelles, la question reste sans réponse : le résultat obtenu est un intervalle numérique, et la vraie tension y est ou n'y est pas.

Illustration

En simulation, en revanche, la vraie tension est connue, et la couverture se lit directement. Si le niveau de 95% décrit bien la procédure, une centaine de répétitions doit produire une poignée d'intervalles qui manquent la cible.
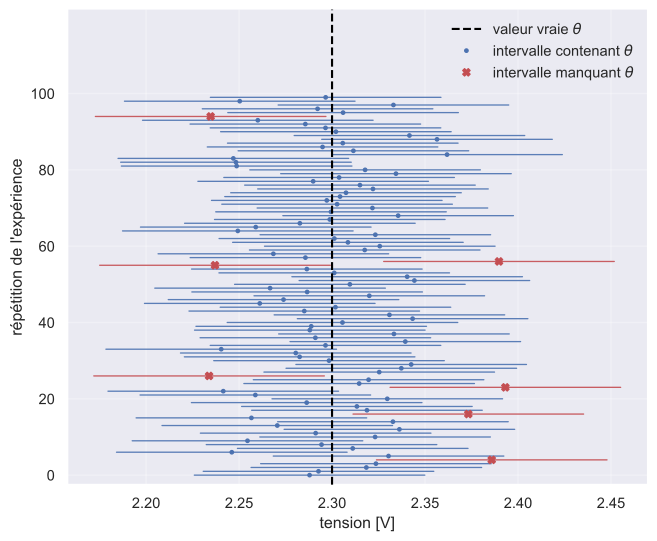
Cent segments horizontaux empilés, un par répétition de l'expérience, chacun
            représentant un intervalle de confiance ; une verticale noire pointillée marque la
            vraie tension, et sept segments rouges marqués d'une croix ne la coupent pas.

Figure 2.3, Cent répétitions indépendantes de la mesure (θ=2,30 V, σ=0,10 V, N=10) et les intervalles de confiance à 95% correspondants ; en rouge, ceux qui ne contiennent pas θ (script figures/ch2/01-intervalle-confiance.py).

Chaque segment est un intervalle obtenu sur un jeu de données différent. Tous ont la même largeur, 2×0,062 V, puisque celle-ci ne dépend que de σ et de N ; seule leur position change, entraînée par x¯. Sept segments sur cent ne coupent pas la verticale : pris isolément, chacun est simplement faux, sans que rien dans les données ne le signale. La couverture observée, 93%, est elle-même une fréquence sur B=100 répétitions, et fluctue autour de 95% comme toute estimation Monte-Carlo.

5. Variance inconnue

L'intervalle du §4 suppose σ connu, ce que la notice d'un appareil fournit parfois. Le cas courant est l'autre : σ doit être estimé sur les mesures elles-mêmes, celles qui servent déjà à estimer θ. Cette section lève cette hypothèse, d'abord en estimant la variance, puis en corrigeant l'intervalle qui en découle.

Définition

Définition, Variance empirique

Pour N mesures i.i.d. de moyenne inconnue, la variance empirique est

σ^2=1N1n=0N1(x[n]x¯)2,

  • x¯ est la moyenne empirique, estimée sur les mêmes données,
  • N1 est le nombre de degrés de liberté restants une fois x¯ fixée.

Le diviseur N1 n'est pas une convention d'usage. Les écarts sont mesurés à x¯ et non à θ, qui est inconnu ; or x¯ est précisément la valeur qui minimise cette somme de carrés. La somme obtenue est donc systématiquement trop petite, et retirer un degré de liberté compense exactement ce rétrécissement.

Propriétés

Proposition, Biais des deux diviseurs

Pour N mesures i.i.d. de variance σ2 :

E[n=0N1(x[n]x¯)2]=(N1)σ2.

L'estimateur à diviseur N1 est donc sans biais, tandis que celui à diviseur N a pour biais σ2/N.

Démonstration

En insérant θ dans chaque écart et en développant, le terme croisé se regroupe :

n(x[n]x¯)2=n(x[n]θ)2N(x¯θ)2.

Le premier terme a pour espérance Nσ2, chaque écart à θ étant de variance σ2. Le second vaut Nvar(x¯)=σ2 en espérance, par la loi de la moyenne empirique. La différence vaut (N1)σ2.

Le biais du diviseur N décroît en 1/N et devient négligeable pour N grand, mais il atteint 10% à N=10. Cette différence est celle du paramètre ddof de NumPy : np.var(x, ddof=1) calcule l'estimateur sans biais, et le défaut ddof=0 l'estimateur biaisé.

Confusion classique

« σ^ est un estimateur sans biais de σ. » Non : le diviseur N1 ne corrige que σ^2. La racine d'une espérance n'étant pas l'espérance d'une racine, E(σ^)<σ, et l'écart-type empirique reste biaisé quel que soit le diviseur retenu.

Remplacer σ par σ^ dans l'intervalle du §4 introduit un second aléa, celui de σ^, que le quantile Gaussien ne prend pas en compte. La correction porte un nom.

Proposition, Intervalle de confiance à variance inconnue

Soient x[n]N(θ,σ2) i.i.d. avec σ inconnu. La variable

t=x¯θσ^/N

suit une loi de Student à ν=N1 degrés de liberté, et l'intervalle

[ x¯t1α/2,νσ^N ,  x¯+t1α/2,νσ^N ]

est de niveau exactement 1α, où t1α/2,ν est le quantile d'ordre 1α/2 de cette loi.

Illustration

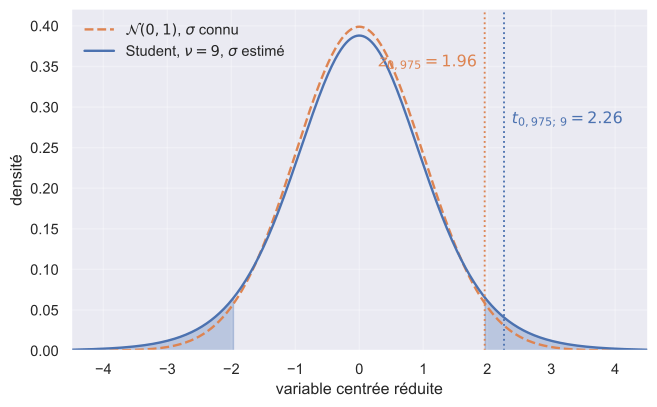
Si l'ignorance de σ se paie, elle doit se lire sur la loi de Student : des queues plus épaisses que celles de la Gaussienne, donc un quantile plus éloigné de zéro à niveau de confiance égal.

Deux densités en cloche presque superposées : la Gaussienne en tirets orange, un peu
            plus haute au centre, et la loi de Student à neuf degrés de liberté en trait bleu, plus
            basse au centre et plus épaisse dans les queues ; deux verticales pointillées marquent
            les quantiles 1,96 et 2,26, et les queues de Student au-delà de 1,96 sont colorées.

Figure 2.4, Loi de Student à ν=9 degrés de liberté et loi N(0,1), avec leurs quantiles d'ordre 0,975 ; en bleu, les queues de Student au-delà du quantile Gaussien (script figures/ch2/01-student-gaussienne.py).

Les deux densités se ressemblent au centre et diffèrent dans les queues, là où se lisent les quantiles. Les aires colorées représentent 8,2% de la masse de Student, alors que la Gaussienne n'en met que 5% au-delà des mêmes bornes : employer z0,975=1,96 avec σ^ ne couvre donc que 91,8% des expériences, trois points sous le niveau annoncé. Le quantile de Student, 2,26, restaure les 95% en élargissant l'intervalle de 15%. Cet élargissement s'atténue avec N : t0,975;29=2,045 à N=30, soit 4% seulement, et la loi de Student tend vers la Gaussienne.

Implémentation

La couverture des deux intervalles se compare par la simulation du §4, en construisant les deux à chaque répétition :

  1. simuler un jeu de N mesures, avec des θ et σ que nous fixons ;
  2. estimer x¯ et σ^ sur ce jeu, puis construire les deux intervalles ;
  3. répéter B fois, puis compter la proportion de chacun qui contient θ.
python
import numpy as np
import scipy.stats as sta
rng = np.random.default_rng(2026)

theta, sigma, N, B = 2.30, 0.10, 10, 100_000
z = sta.norm.ppf(0.975)
t = sta.t.ppf(0.975, N - 1)              # >>> 2.2622  (Gaussian quantile: 1.96)

covered_z, covered_t = 0, 0
for b in range(B):
    x = rng.normal(theta, sigma, N)       # one repetition of the experiment
    mean, sigma_hat = x.mean(), x.std(ddof=1)
    half_width = sigma_hat / np.sqrt(N)
    if abs(mean - theta) <= z * half_width:
        covered_z += 1                    # naive interval, Gaussian quantile
    if abs(mean - theta) <= t * half_width:
        covered_t += 1                    # Student interval

coverage_z = covered_z / B                # >>> 0.9179  (predicted: 0.9184)
coverage_t = covered_t / B                # >>> 0.9493  (predicted: 0.95)

L'intervalle naïf n'est pas seulement imprécis, il est trop étroit : il annonce 95% et en tient 92%. Une couverture inférieure au niveau affiché est le défaut le plus grave d'un intervalle, puisqu'il conduit à surestimer la confiance accordée au résultat.

Exemple : mesure d'une tension

Reprenons les dix mesures du §4, en supposant cette fois la notice du voltmètre indisponible. Les mêmes données donnent x¯=2,288 V et σ^=0,0875 V, d'où une demi-largeur 2,262×0,0875/10=0,063 V et l'intervalle de confiance à 95%

[2,225 ; 2,351] V.

Il est presque identique à celui du §4, [2,226 ; 2,350] V, car deux effets se compensent : σ^=0,0875 V sous-estime ici σ=0,10 V, et le quantile de Student, plus grand, rattrape cet écart. Cette coïncidence ne vaut que pour ce tirage : sur l'ensemble des répétitions, seule la version de Student tient son niveau.