
Lois continues
La page Fondations a posé les outils pour décrire une v.a. continue, densité, fonction de répartition, espérance et variance, indépendance, et la synthèse qui les chapeaute : une loi est un modèle paramétré
Loi uniforme continue,
La loi uniforme continue modélise une valeur prise « au hasard » dans un intervalle
Modélisation
La loi uniforme continue est paramétrée par
Modèle (Loi uniforme continue)
- PDF :
- CDF :
Illustration

Figure 1.16a, PDF : rectangles de hauteur

Figure 1.16b, CDF : rampe linéaire sur
Propriétés
Moments
Le centre reste le même que pour la version discrète ; la dispersion croît avec la largeur de l'intervalle, au carré.
Exemple
Le code suivant montre comment tirer 100 000 erreurs de quantification au pas
import numpy as np
rng = np.random.default_rng(0)

u = rng.uniform(-0.5, 0.5, size=100_000)
u.mean(), u.var() # >>> (-0.0004, 0.0832) (≈ 0, q²/12 = 0.0833)import scipy.stats as sta
X = sta.uniform(loc=-0.5, scale=1.0) # loc = a, scale = b - a (et non b)
X.var() # >>> 0.0833
X.cdf(0.25) # >>> 0.75Loi exponentielle,
La loi exponentielle modélise la durée d'attente d'un événement sans mémoire : le temps entre deux pannes, entre deux requêtes. C'est la jumelle continue de la Poisson : si les événements se comptent en Poisson de taux
Modélisation
La loi exponentielle est paramétrée par
Modèle (Loi exponentielle)
- PDF :
- CDF :
Illustration

Figure 1.17a, PDF : part de

Figure 1.17b, CDF :
Propriétés
Moments
L'écart-type est égal à la moyenne : la loi est fortement asymétrique, elle servira de loi « pas du tout Gaussienne » pour mettre le TCL à l'épreuve en fin de fiche normale.
Preuve
Par intégration par parties,
L'absence de mémoire
Proposition, Absence de mémoire (exponentielle)
Si
Une machine qui fonctionne depuis
Démonstration
Exemple
Le code suivant montre comment tirer 100 000 durées entre pannes d'un serveur de taux
import numpy as np
rng = np.random.default_rng(0)

t = rng.exponential(scale=2.0, size=100_000)   # scale = 1/λ
t.mean(), t.var()   # >>> (1.994, 4.016)  (≈ 2, 4)
np.mean(t > 3) # >>> 0.2226 (≈ e^{-1.5})import scipy.stats as sta
X = sta.expon(scale=2.0)
X.sf(3) # >>> 0.2231
X.sf(5) / X.sf(2) # >>> 0.2231 (= P(X > 3) : sans mémoire)Loi normale,
La loi normale modélise le bruit de mesure, et plus généralement toute grandeur résultant de l'accumulation de petits effets indépendants. Sa densité est la célèbre courbe en cloche, symétrique.
Modélisation
La loi normale est paramétrée par
Modèle (Loi normale)
- PDF :
- CDF :
où scipy) de
Illustration

Figure 1.18a, PDF :

Figure 1.18b, CDF : une rampe en S, centrée en
Propriétés
Moments
Remarquons que les paramètres de la loi sont exactement ses deux premiers moments.
La standardisation
Toutes les Gaussiennes se déduisent d'une seule,
Proposition, Standardisation (centrage-réduction)
Si
la loi normale centrée réduite, de fonction de répartition notée
La règle 68–95–99,7
La standardisation fige quelques probabilités de référence, valables pour n'importe quelle Gaussienne.
| Écart au centre | Intervalle | |
|---|---|---|
C'est la règle mnémotechnique 68–95–99,7. Le quantile

Figure 1.19, La règle 68–95–99,7 : quelle que soit la Gaussienne, environ 68 % de la probabilité vit à figures/ch1/03-normale-68-95-997.py).
Le théorème central limite
Reste la question soulevée en tête de fiche : pourquoi cette loi serait-elle si répandue, alors que le réel n'est pas toujours en cloche (le marathon) ? La réponse tient dans le théorème le plus célèbre des probabilités. Il porte sur la somme de v.a. i.i.d., abréviation d'indépendantes et identiquement distribuées : les
Deux façons pour une suite de variables aléatoires de « se rapprocher » d'une limite
Une suite de v.a.
Théorème central limite (TCL)
Soient
ce qui s'utilise en pratique sous la forme : pour
L'énoncé est admis. Son point remarquable est l'universalité : quelle que soit la loi de départ, dé, exponentielle, Bernoulli, sommer suffit à faire émerger la Gaussienne. D'où la justification de la phrase d'ouverture de cette fiche : toute grandeur qui accumule un grand nombre de petits effets indépendants (un bruit de capteur, une somme d'erreurs élémentaires) est presque une somme de v.a. i.i.d., donc approximativement Gaussienne par TCL. C'est cet argument qui motive, dans tout le cours, la modélisation Gaussienne des composantes de bruit.
Exemple de convergence : sommer des exponentielles
Le théorème se met à l'épreuve sur la loi la plus asymétrique du catalogue,

Figure 1.20, Gaussianisation de la somme figures/ch1/03-tcl-convergence.py).
Conséquence : la loi de la moyenne
L'analyse de données ne somme pas ses mesures, elle les moyenne. Le théorème s'y transpose sans calcul supplémentaire : la moyenne empirique
Corollaire, loi de la moyenne empirique
Sous les hypothèses du théorème central limite, pour
Les deux paramètres se lisent directement sur ceux de
C'est sous cette forme que le TCL servira dans tout le cours : la Gaussienne est la loi des moyennes. Le chapitre 2 en fait son point de départ, la moyenne empirique y devenant le premier estimateur rencontré.
Loi normale multidimensionnelle,
Une mesure isolée n'est pas toujours la situation la plus riche : deux capteurs relevés ensemble, deux coordonnées d'une position, ou plus généralement un vecteur de
Modélisation
La loi normale multidimensionnelle est paramétrée par
Modèle (Loi normale multidimensionnelle)
- PDF :
Illustration
Pour
Ce que

Figure 1.21a,

Figure 1.21b, figures/ch1/03-normale-2d.py).
Le nuage rond correspond à
Propriétés
Moments
Le cas non corrélé
Si
Pour une Gaussienne, absence de corrélation et indépendance coïncident, un résultat qui ne vaut pas pour une loi quelconque. Un bruit blanc (
Exemple
Le code suivant montre comment évaluer la densité de deux capteurs bruités corrélés à
import numpy as np

def densite_normale_2d(x, mu, C):
    """Densité de N(mu, C) en dimension 2."""
    ecart = x - mu
    inv_C = np.linalg.inv(C)
    det_C = np.linalg.det(C)
    exposant = -0.5 * ecart @ inv_C @ ecart
    return np.exp(exposant) / (2 * np.pi * np.sqrt(det_C))

mu = np.array([0.0, 0.0])
C = np.array([[1.0, 0.8], [0.8, 1.0]])
densite_normale_2d(np.array([0.0, 0.0]), mu, C) # >>> 0.2653 (le pic)import scipy.stats as sta
X = sta.multivariate_normal(mean=[0.0, 0.0], cov=[[1.0, 0.8], [0.8, 1.0]])
X.pdf([0.0, 0.0]) # >>> 0.2653
ech = X.rvs(size=100_000, random_state=0)
np.cov(ech.T) # >>> [[1.00, 0.80], [0.80, 1.01]] (≈ C)Au chapitre 2 : ce modèle, plusieurs mesures bruitées et corrélées à la fois, sera au cœur de la dérivation des moindres carrés.
Récapitulatif : une loi = un modèle paramétré
Le catalogue est complet. Reprenons la lecture posée en fondations, §5, une loi est un modèle paramétré
| Loi | Situation-type | |||
|---|---|---|---|---|
| Bernoulli | conversion d'un test A/B | |||
| Binomiale | bits erronés sur une trame | |||
| Géométrique | attente du premier succès | |||
| Poisson | requêtes par seconde | |||
| Uniforme discrète | le dé | |||
| Uniforme | erreur de quantification | |||
| Exponentielle | temps entre deux pannes | |||
| Normale | bruit de mesure |
Huit situations, une seule idée : chaque ligne est un modèle scipy.stats (fondations, §5.3) : le même code fonctionne pour les huit lois en changeant la première ligne, sta.bernoulli(p), sta.binom(n,p), sta.geom(p), sta.poisson(lam), sta.randint(a, b+1), sta.uniform(loc=a, scale=b-a), sta.expon(scale=1/lam), sta.norm(loc=mu, scale=sigma).
Transformation d'une variable aléatoire
Les sections précédentes décrivent une variable aléatoire dont la loi est donnée. Deux besoins inverses se présentent en pratique : déduire la loi d'une quantité calculée à partir d'une autre,
Changement de variable
Proposition, Changement de variable
Soit
où
est la fonction réciproque de , - le facteur
corrige la dilatation locale de l'axe.
Démonstration
Pour
Dériver les deux membres par rapport à
Le cas de loin le plus fréquent est la transformation affine,
Méthode de la transformation inverse
Un ordinateur ne sait engendrer qu'une seule loi, l'uniforme sur
Théorème, Transformation inverse
Soit
admet
Démonstration
Le mécanisme se comprend mieux en le regardant opérer. Tirer
Illustration
Si le théorème est exact, des
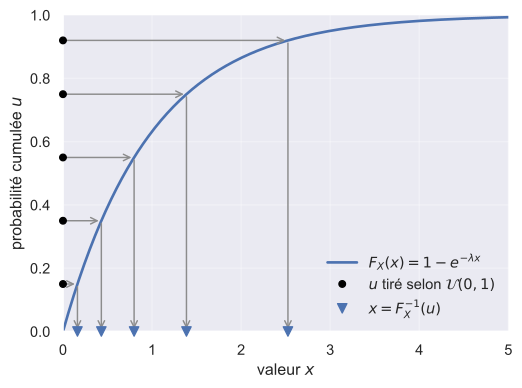
Figure 1.22a, La transformation inverse en action sur la loi exponentielle (figures/ch1/03-transformation-inverse.py).
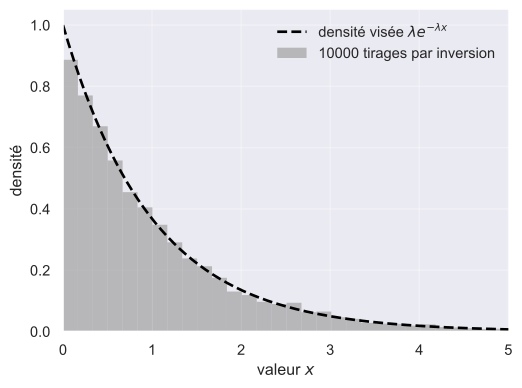
Figure 1.22b, Dix mille tirages produits par cette méthode, confrontés à la densité visée.
À gauche, les cinq
Le cas discret
Une fonction de répartition discrète progresse par paliers et n'est donc pas inversible au sens strict. La construction se transpose en retenant la première valeur dont la probabilité cumulée dépasse
Géométriquement, l'axe
Implémentation
La méthode s'écrit en trois étapes, identiques dans les deux cas :
- tirer
uniformément sur , autant de fois que de valeurs souhaitées ; - inverser la fonction de répartition, analytiquement si elle s'inverse, par recherche dans les probabilités cumulées sinon ;
- vérifier l'échantillon obtenu contre la loi visée, moyenne et variance empiriques, ou histogramme.
import numpy as np
rng = np.random.default_rng(2026)

M, lam = 10_000, 1.0

# continuous case: F(x) = 1 - exp(-lam x) inverts in closed form
u = rng.random(M)
x = -np.log(1.0 - u) / lam
x.mean()                                  # >>> 1.0202  (expected: 1 / lam = 1)

# discrete case: a loaded die, the first value whose cumulated mass exceeds u
pmf = np.array([0.10, 0.10, 0.10, 0.10, 0.10, 0.50])
cdf = np.cumsum(pmf)
faces = np.searchsorted(cdf, rng.random(M)) + 1
np.mean(faces == 6) # >>> 0.4945 (expected: 0.50)import scipy.stats as sta
X = sta.expon(scale=1 / lam)
X.rvs(size=M, random_state=2026).mean() # >>> 1.0047 (expected: 1 / lam = 1)
X.ppf(0.5) # >>> 0.6931 (the median, ln 2 / lam)La méthode rvs de scipy.stats (section 5.3 des fondations) ne fait rien d'autre : elle applique ppf (percent point function), à des tirages uniformes.
Limites
La méthode exige de savoir inverser sta.norm.ppf. La seconde emprunte une transformation différente, la transformation de Box-Muller, qui produit deux Gaussiennes centrées réduites indépendantes à partir de deux uniformes indépendantes :
Sa démonstration relève du changement de variable en dimension deux ; sa mise en œuvre fait l'objet du projet Les lois usuelles en NumPy, qui recode ainsi les tirages de tout le catalogue du chapitre.
Adéquation d'un modèle
Le catalogue fournit huit modèles ; rien n'a encore dit comment vérifier que celui retenu convient aux données. Comment confronter une loi
Définition
Définition, Diagramme quantile-quantile
Le diagramme quantile-quantile (QQ-plot) porte les quantiles du modèle en abscisse et les quantiles observés en ordonnée. Pour
où
est la fonction quantile du modèle, l'inverse de sa fonction de répartition, est la -ème plus petite mesure, est la fraction de l'échantillon située sous cette mesure.
Si le modèle décrit les données, les points s'alignent sur la première bissectrice.
La lecture est immédiate : un point au-dessus de la bissectrice signale une mesure plus grande que ce que le modèle prévoit à ce rang, un point en dessous une mesure plus petite. Un décrochage aux deux extrémités, en arc, révèle une asymétrie que le modèle ne reproduit pas.
Illustration
L'histogramme des chronos de marathon de la figure 1.4 s'étirait vers la droite. Si la loi normale, symétrique, décrit mal cette asymétrie, l'écart doit rester discret sur l'histogramme et éclater sur le diagramme quantile-quantile.
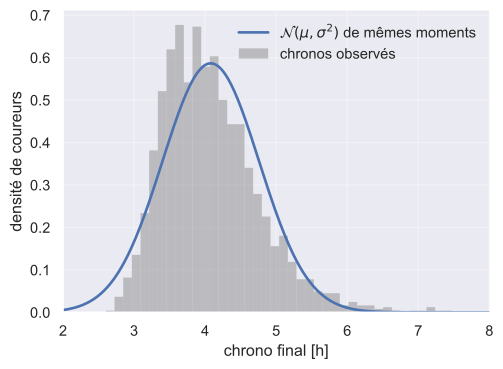
Figure 1.23a, Chronos de figures/ch1/03-adequation-marathon.py).
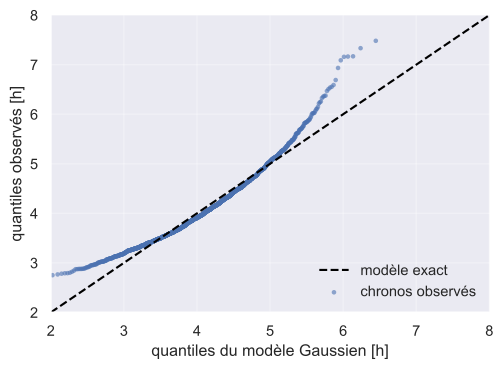
Figure 1.23b, Diagramme quantile-quantile des mêmes chronos contre cette loi normale ; la bissectrice correspond à un modèle exact.
À gauche, la Gaussienne suit correctement le corps de la distribution, et l'œil hésite à la rejeter. À droite, les points quittent la bissectrice aux deux extrémités et dessinent un arc, la signature d'une loi asymétrique confrontée à un modèle symétrique. Le désaccord se chiffre : le modèle prévoit
Confusion classique
« La densité superposée épouse l'histogramme, donc le modèle convient. » Non : l'histogramme est dominé par le corps de la distribution, là où se concentrent les effectifs. Les queues, qui portent les événements rares et souvent les plus coûteux, y sont pratiquement invisibles.
Implémentation
Le diagramme se construit en trois lignes, et scipy en fournit une version toute faite :
import numpy as np
import scipy.stats as sta
rng = np.random.default_rng(2026)

# the marathon times of figure 1.4, simulated from a shifted lognormal
chronos = 2.0 + rng.lognormal(mean=np.log(2.0), sigma=0.32, size=2_000)
chronos = chronos[chronos < 7.5]

x = np.sort(chronos)                              # the N measurements, sorted
p = (np.arange(1, x.size + 1) - 0.5) / x.size     # plotting positions
q = sta.norm.ppf(p, x.mean(), x.std())            # quantiles of the model
# then plot x against q, together with the first bisectorimport matplotlib.pyplot as plt
import scipy.stats as sta
sta.probplot(chronos, dist="norm", plot=plt)
# quantiles are standardised here: the reference is the least-squares line,
# not the first bisectorCes deux lectures restent qualitatives : elles montrent un désaccord sans le quantifier, et deux personnes peuvent lire le même diagramme différemment. Le chapitre 3 transforme ce jugement en décision chiffrée, en traitant l'adéquation d'un modèle comme un problème de détection.