Skip to content

Tests d'adéquation

Les cinq détecteurs de la page précédente choisissaient entre deux lois données. Le chapitre 1 a posé la question qui vient avant, la loi retenue décrit-elle les données, et l'a tranchée à l'œil. Cette page en fait une décision chiffrée : la section 1 pose l'adéquation comme un problème de détection, la section 2 construit le test du χ2, la section 3 en tire la p-value, la section 4 délimite ce qu'un tel test permet de conclure.

1. Problématique

Un serveur enregistre le nombre de requêtes reçues chaque seconde pendant N=200 secondes. La loi de Poisson est le modèle naturel de ce comptage, mais rien ne garantit que ses hypothèses tiennent : un trafic par rafales, par exemple, produit des comptages bien plus dispersés que ce qu'elle prévoit. Comment décider, sur les données, si le modèle est acceptable ?

La question se coule dans le cadre de la page précédente, à ceci près que l'hypothèse porte cette fois sur le modèle lui-même :

H0:x[n]p(x;θ0),H1:les données ne suivent pas cette loi.

Les deux hypothèses ne sont pas de même nature. Seule H0 est spécifiée : H1 rassemble toutes les autres lois possibles, sans en désigner aucune. La probabilité de fausse alarme reste donc calculable, rejeter un modèle pourtant vrai, mais la probabilité de détection ne l'est pas, puisqu'elle dépend de l'alternative, qu'il faut choisir pour l'évaluer.

Cette asymétrie a une conséquence qui gouverne toute la page : le test rejette ou ne rejette pas, il ne valide jamais.

2. Test du χ2 d'adéquation

Hypothèses

Trois hypothèses définissent ce cadre :

  • Données groupées. Les observations sont réparties en K classes disjointes couvrant tout le support du modèle. Le symbole K compte ici des classes, non des hypothèses comme au §3 des fondations.
  • Effectifs suffisants. Chaque classe reçoit un effectif attendu n^k5, faute de quoi les classes voisines sont fusionnées.
  • Paramètres estimés par maximum de vraisemblance. Si r paramètres du modèle sont inconnus, ils sont estimés sur les mêmes données, par MLE.

Expression

L'idée est de comparer, classe par classe, l'effectif observé à celui que le modèle prédit.

Définition, Statistique du χ2 d'adéquation

La statistique de test est la somme des écarts quadratiques normalisés :

T(x)=k=1K(nkn^k)2n^k,

  • nk est l'effectif observé de la classe k,
  • n^k=NP(classe k;θ^) est l'effectif attendu sous le modèle, dont le chapeau rappelle qu'il dépend du paramètre estimé,
  • K est le nombre de classes.

Chaque terme est un écart au carré rapporté à l'effectif attendu, la variance d'un comptage étant elle-même de l'ordre de cet effectif : une différence de dix unités ne pèse pas le même poids sur une classe qui en attend douze et sur une classe qui en attend mille. La statistique est nulle pour un accord parfait et grandit dès qu'une classe s'écarte, dans un sens ou dans l'autre. La règle de décision est celle de toute la page précédente, décider H1 si T(x)>γ.

Propriétés

Proposition, Loi asymptotique sous H0

Sous H0, quand N, la statistique T suit une loi du χ2 à

ν=K1r

degrés de liberté, où r est le nombre de paramètres du modèle estimés sur les données.

Les deux soustractions ont chacune leur cause. Le 1 vient de ce que les effectifs somment à N : la dernière classe se déduit des autres. Le r vient de ce que chaque paramètre estimé rapproche mécaniquement le modèle des données, et diminue donc l'écart mesuré. Cette statistique est par ailleurs une approximation du GLRT, dont la dérivation fait l'objet du projet Tests classiques : le χ2 n'est pas une recette isolée, c'est une instance du cadre de la page précédente.

Confusion classique

« Le nombre de degrés de liberté vaut K1. » Non, pas dès qu'un paramètre est estimé sur les données. Dans l'exemple ci-dessous, retenir ν=6 au lieu de 5 porte le seuil de 11,07 à 12,59 : le test ne rejette plus qu'une fois sur trente-sept sous H0, au lieu d'une fois sur vingt.

Implémentation

Les quatre étapes du §2 de la page précédente valent ici sans changement, l'étape de calibration comprise :

  1. grouper les observations en classes et compter les effectifs observés ;
  2. estimer les paramètres du modèle, puis en déduire les effectifs attendus ;
  3. évaluer la statistique T ;
  4. comparer au seuil, lu sur la loi du χ2 ou calibré par simulation sous H0.
python
import numpy as np
import scipy.stats as sta

edges = np.array([0, 2, 3, 4, 5, 6, 7])       # class lower bounds, last one open

def observed(x):
    """Counts per class; the last class gathers everything above its bound."""
    return np.histogram(x, bins=np.append(edges, 1e9))[0]

def expected(x):
    """Counts predicted by a Poisson model whose parameter is fitted on x."""
    lam = x.mean()                             # MLE of the Poisson parameter
    hi = sta.poisson.cdf(np.append(edges[1:] - 1, np.inf), lam)
    lo = sta.poisson.cdf(edges - 1, lam)
    return len(x) * (hi - lo)

def T(x):
    """Chi-square goodness-of-fit statistic."""
    o, e = observed(x), expected(x)
    return np.sum((o - e) ** 2 / e)

nu = len(edges) - 1 - 1                        # K - 1 - r, one parameter fitted
gamma = sta.chi2.ppf(0.95, nu)                 # >>> 11.0705  (nu = 5)
python
import scipy.stats as sta

# ddof counts the parameters fitted on the data; scipy then uses K - 1 - ddof
stat, p_value = sta.chisquare(observed(x), expected(x), ddof=1)

Le seuil peut aussi se calibrer sans invoquer la loi asymptotique, par la simulation de Monte-Carlo : engendrer B échantillons sous H0, réestimer les paramètres sur chacun, et lire le quantile empirique de T. Cette voie est plus lente mais plus sûre, puisqu'elle ne suppose ni N grand ni effectifs suffisants.

Illustration

Si la proposition est exacte, l'histogramme de T obtenu par simulation sous H0 doit se superposer à la densité du χ2 à 5 degrés de liberté, et le quantile empirique à 95% retomber sur le seuil théorique.
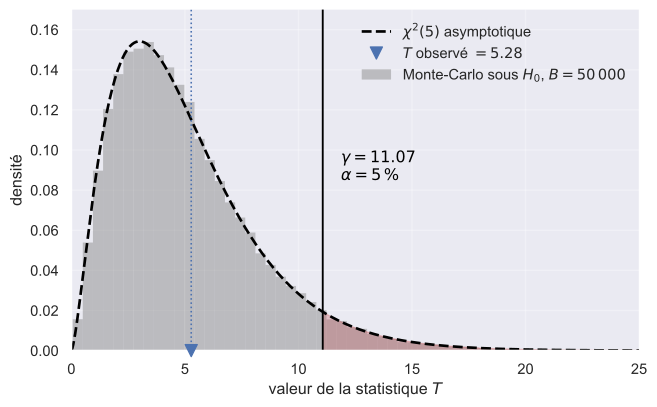
Histogramme gris de la statistique T simulée sous H0, exactement recouvert par la
            densité du chi-2 à cinq degrés de liberté en tirets noirs ; une verticale noire en
            11,07 sépare une queue droite colorée en rouge, et un triangle bleu marque la valeur
            observée 5,28.

Figure 3.9, Loi de T sous H0 (λ=4, N=200, 50000 répétitions) et densité χ2(5) ; en rouge la zone de rejet au niveau α=5%, au-delà de γ=11,07 (script figures/ch3/03-adequation-loi-h0.py).

L'histogramme épouse la densité théorique, et le quantile empirique à 95% vaut 11,02 contre 11,07 pour le χ2(5) : la loi asymptotique est déjà acquise à N=200. La zone rouge représente exactement le budget de fausse alarme, la fraction des échantillons conformes au modèle que le test rejetterait pourtant.

Exemple : requêtes sur un serveur

Deux séries de N=200 comptages sont soumises au même test, au niveau α=5%. La première est réellement issue d'une loi de Poisson ; la seconde provient d'un trafic par rafales, de même moyenne mais de variance double.

SérieMoyenneVarianceTDécision
Trafic régulier4,234,515,28non rejeté
Trafic par rafales4,067,2649,1rejeté

La première série donne T=5,28, bien en deçà de γ=11,07 : rien dans ces données ne contredit le modèle de Poisson. La seconde donne T=49,1, plus de quatre fois le seuil. La colonne des variances dit pourquoi : la loi de Poisson impose var(X)=E(X), or la seconde série affiche une variance de 7,26 pour une moyenne de 4,06. Le test du χ2 chiffre ce que la comparaison de la moyenne et de la variance suggérait déjà en fiche Poisson.

3. La p-value

Le test précédent exige de fixer α avant de regarder les données. Rendre compte du résultat sans imposer ce choix au lecteur demande de publier, non pas la décision, mais le budget de fausse alarme auquel elle bascule.

Définition

Définition, p-value

La p-value d'une observation est la probabilité, sous H0, d'obtenir une statistique au moins aussi grande que celle observée :

p=P(TTobs;H0),

  • Tobs est la valeur de la statistique sur les données reçues,
  • la probabilité est calculée sous le modèle H0, seul entièrement spécifié.

La p-value est donc la PFA du test dont le seuil vaudrait exactement Tobs : sur la figure 3.9, c'est l'aire sous la densité à droite du triangle bleu. Décider H1 quand p<α est rigoureusement la règle T>γ, réécrite sur l'axe des probabilités. Pour les deux séries de l'exemple, p=0,38 et p=2109.

Confusion classique

« p=0,38, donc le modèle a 38% de chances d'être vrai. » Non : la p-value est une probabilité sur les données, calculée en supposant H0 vraie, jamais une probabilité sur l'hypothèse. C'est l'erreur déjà rencontrée sur l'intervalle de confiance, où les 95% portaient sur la procédure et non sur θ.

4. Portée et limites

Illustration

Un test qui ne rejette pas ne dit rien tant que sa capacité à rejeter n'est pas connue. Confrontons donc le test au trafic par rafales, un modèle faux par construction, pour différentes tailles d'échantillon.
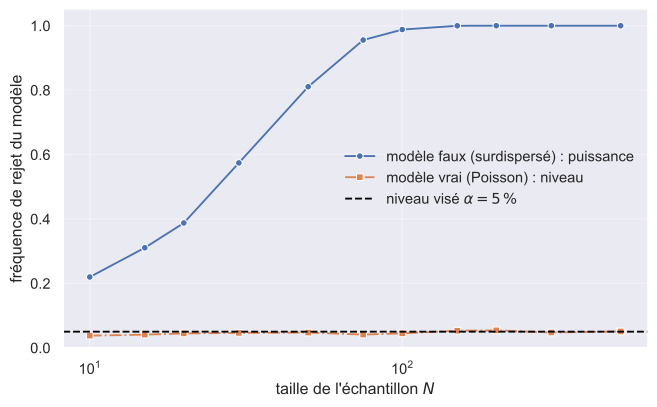
Deux courbes en fonction de N en échelle logarithmique : la fréquence de rejet du
            modèle faux monte de 0,22 à 1, tandis que celle du modèle vrai reste plate au
            voisinage de la ligne horizontale noire à 0,05.

Figure 3.10, Fréquence de rejet du modèle de Poisson au niveau α=5% en fonction de N, sur des données réellement Poisson et sur des données surdispersées de même moyenne (4000 répétitions par point) (script figures/ch3/03-adequation-puissance.py).

La courbe orange reste collée au niveau visé quelle que soit la taille de l'échantillon : le test tient sa promesse de fausse alarme. La courbe bleue, elle, part de très bas : à N=20, un modèle pourtant faux n'est rejeté que dans 39% des cas, et il faut N=100 pour que le rejet devienne quasi certain. Sur un petit échantillon, un test qui ne rejette pas n'établit donc rien du tout, il constate seulement qu'il n'avait pas les moyens de conclure.

Confusion classique

« Le test ne rejette pas, donc le modèle est bon. » Non : ne pas rejeter, c'est manquer de preuves contre le modèle, jamais en avoir pour lui. La figure 3.10 le chiffre : à N=20, six fois sur dix, un modèle faux traverse le test sans encombre.

Le défaut symétrique guette à l'autre extrémité. Aucun modèle n'est exactement vrai, et la puissance croît avec N : sur un échantillon assez grand, tout modèle finit par être rejeté, y compris un excellent modèle dont l'écart au réel est sans conséquence pratique. La décision d'un test d'adéquation se lit donc toujours avec la taille de l'échantillon à côté, et un écart statistiquement significatif n'est pas nécessairement un écart qui compte.

Extension : données continues (Kolmogorov-Smirnov)

Le χ2 exige un groupement en classes, naturel pour un comptage, arbitraire pour une variable continue : deux découpages différents peuvent conduire à deux conclusions différentes. Le test de Kolmogorov-Smirnov s'en dispense en comparant directement les deux fonctions de répartition :

D=supx|FN(x)F(x;θ0)|,

F(;θ0) est la fonction de répartition du modèle et FN la fonction de répartition empirique, définie par

FN(x)=#{n : x[n]x}N,

c'est-à-dire la proportion des mesures qui ne dépassent pas x. Comme toute fonction de répartition, elle croît de 0 à 1, ici par paliers de 1/N. La statistique D est l'écart vertical maximal entre les deux courbes, et sta.kstest la calcule.

Une réserve accompagne son usage courant. La loi de D sous H0 n'est tabulée que si θ0 est entièrement spécifié ; dès que des paramètres sont estimés sur les données, les seuils des tables deviennent trop permissifs et le seuil doit être calibré par simulation. Sur les chronos de marathon du chapitre 1, D=0,060 pour 1998 coureurs, à comparer au seuil tabulé de 0,030 et au seuil calibré par Monte-Carlo, 0,020 : la loi normale est rejetée par les deux, mais le seuil correct est une fois et demie plus sévère que celui de la table. Le diagramme quantile-quantile du chapitre 1 et cette valeur de D disent la même chose, l'un en montrant où le modèle échoue, l'autre en chiffrant de combien.

5. Résumé

Deux tests ont été construits dans cette page, tous deux instances du cadre de la page précédente, appliqué cette fois au modèle lui-même.

TestStatistique T(x)DonnéesLoi sous H0
χ2k(nkn^k)2/n^kgroupées en classesχ2(K1r), asymptotique
Kolmogorov-Smirnovsupx|FN(x)F(x;θ0)|continues, non groupéestabulée si θ0 connu, simulée sinon

Le choix entre les deux suit la nature des données, comptages contre mesures continues, et non la commodité. Dans les deux cas, le seuil se lit sur une loi de référence quand ses conditions sont réunies, et se calibre par simulation sous H0 sinon, ce qui reste la voie la plus sûre dès que des paramètres sont estimés. Et dans les deux cas la conclusion s'énonce dans un seul sens : le modèle est rejeté, ou il résiste à ce test, sur cet échantillon, avec cette puissance.